Strona może nie indeksować się w Google, ponieważ wyszukiwarka jeszcze jej nie odkryła, nie może pobrać zawartości, odczytuje zakaz indeksowania albo wybiera inny adres jako główną wersję tej samej treści. Możliwy jest też brak indeksacji mimo poprawnej konfiguracji technicznej. Zacznij od sprawdzenia konkretnego URL-a w Google Search Console, a następnie usuń przyczynę wskazaną przez dane. Sam brak strony na wybraną frazę nie dowodzi problemu z indeksem. Poniższa procedura pomoże ustalić, co sprawdzić samodzielnie, co przekazać wykonawcy i jak ocenić poprawkę. [1][2]
Najważniejsze informacje w skrócie
- Indeksacja i pozycja to dwie różne sprawy. Adres może znajdować się w indeksie, a mimo to nie wyświetlać się na interesujące Cię zapytanie. [2]
- Sprawdzaj dokładny URL. Warianty z innym protokołem, subdomeną lub parametrem mogą mieć różny stan. [5]
- Kod HTTP 200 to początek kontroli. Potwierdza poprawną odpowiedź serwera, ale nie gwarantuje indeksacji ani obecności właściwej treści. [1][3]
- Test wersji opublikowanej nie jest odczytem indeksu. Pomaga sprawdzić bieżącą dostępność; dane o indeksacji odnoszą się do wersji znanej Google. [5]
- robots.txt, noindex i canonical mają inne zadania. Pierwszy steruje pobieraniem, drugi wyklucza indeksowanie, trzeci wskazuje preferowaną wersję treści. [8][9][10]
- Mapa XML i prośba o indeksację nie zapewniają przyjęcia strony do indeksu. Ponawianie zgłoszenia tego samego adresu nie przyspiesza skanowania. [12][13]
- Po naprawie sprawdź nie tylko brak błędu, ale też stan docelowego adresu. Zachowaj datę wdrożenia i wynik kontroli, żeby porównać je z późniejszym odczytem.
Spis treści
Czy URL jest dostępny
W pierwszej kolejności ustal, który adres ma pojawiać się w Google i czy jest przeznaczony do publicznego wyszukiwania. Strona oferty, opis usługi czy poradnik zwykle mają taki cel. Panel klienta, koszyk lub prywatny dokument mogą być celowo wyłączone. Nie próbuj doprowadzić do indeksacji wszystkich adresów w serwisie tylko dlatego, że raport zawiera pozycje oznaczone jako niezindeksowane.
Zapisz pełną postać adresu URL, na przykład https://example.com/oferta/. Sprawdź go po wylogowaniu z panelu administracyjnego. Zwróć uwagę, czy przeglądarka pozostaje pod tym URL-em, czy przechodzi do innego. Jeżeli następuje prawidłowe przekierowanie na nowy adres oferty, dalszą diagnozę prowadź także dla adresu docelowego. Nie oceniaj indeksowania nowej strony wyłącznie na podstawie starego odnośnika.
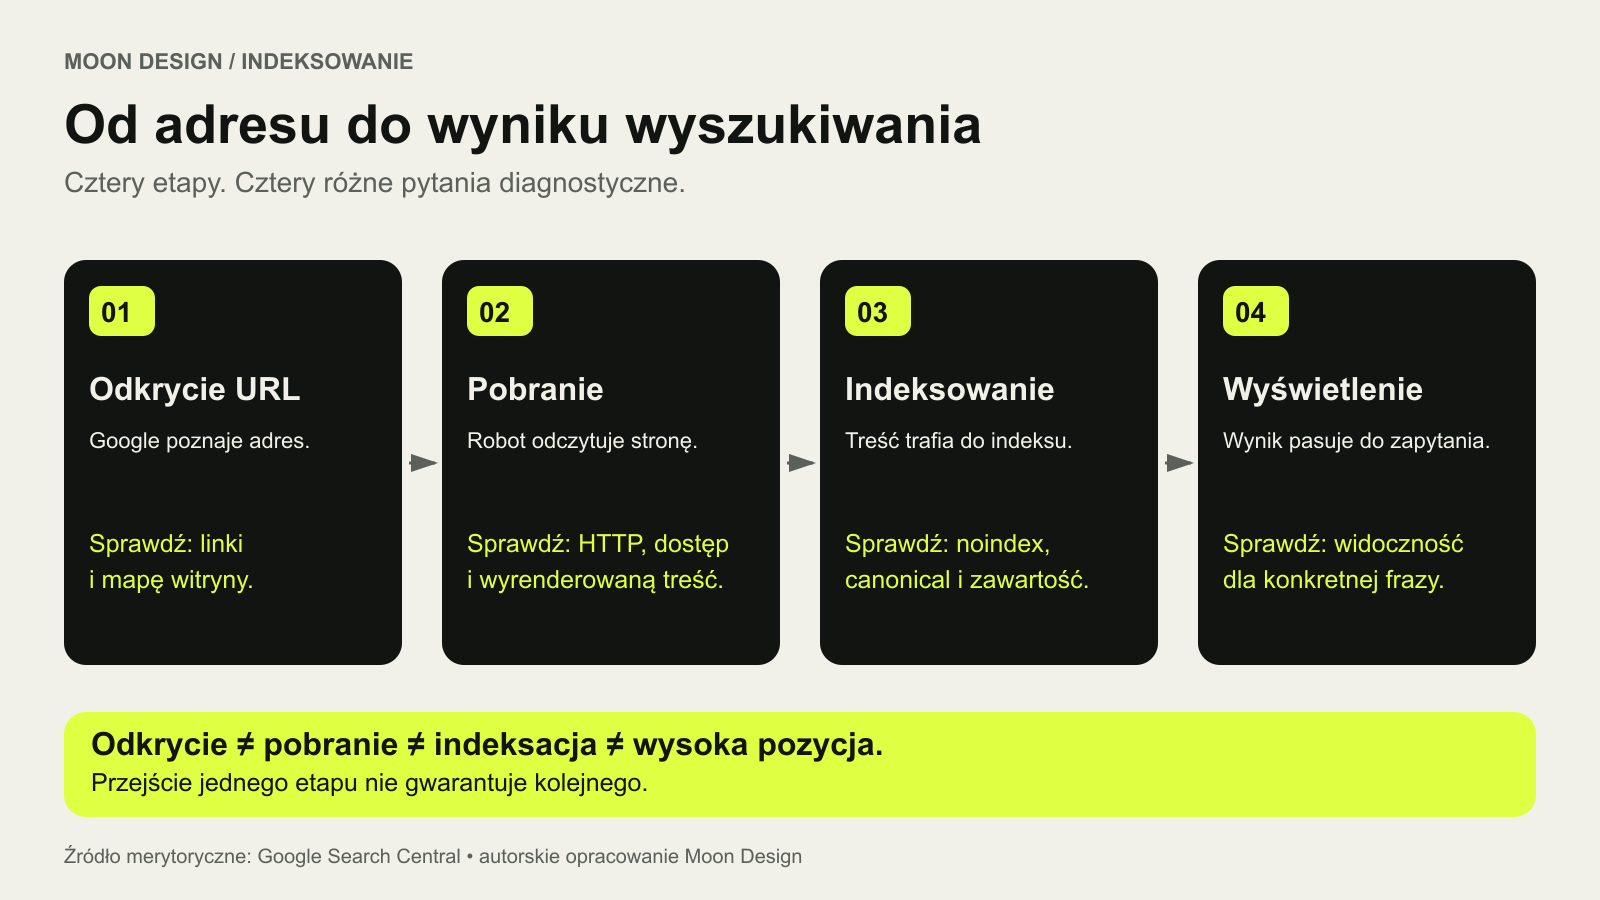
Warto rozdzielić cztery etapy: odkrycie adresu, pobranie strony, przetworzenie jej do indeksu Google oraz wybór wyniku dla konkretnego zapytania. Googlebot, czyli robot pobierający strony dla Google, może znać URL, lecz jeszcze nie odwiedzić go. Może też pobrać treść, która ostatecznie nie zostanie zindeksowana. Z kolei indeksowanie stron nie zapewnia wysokiej pozycji w wynikach wyszukiwania. [2]
Sprawdź odpowiedź serwera, nie tylko wygląd strony. Kod HTTP to informacja techniczna wysyłana razem z odpowiedzią na żądanie przeglądarki lub robota. Można go odczytać w narzędziach deweloperskich przeglądarki, w zakładce sieciowej, wybierając główny dokument po ponownym wczytaniu. Jeśli nie pracujesz z takimi narzędziami, poproś wykonawcę o kod odpowiedzi i pełną ścieżkę przekierowań dla wskazanego adresu.
| Wynik kontroli | Znaczenie dla diagnozy | Co zrobić |
|---|---|---|
| HTTP 200 i właściwa zawartość | Dokument został poprawnie zwrócony. | Przejdź do kontroli indeksowania. |
| Przekierowanie 301 lub 302 | Odpowiedź prowadzi do innego URL-a. | Sprawdź cel, zasadność przekierowania i brak pętli przekierowań. |
| 401 lub 403 | Dostęp wymaga uprawnień albo został odrzucony. | Sprawdź logowanie, reguły zapory i zabezpieczenia hostingu. |
| 404 lub 410 | Zasób nie jest dostępny pod tym adresem. | Przywróć go, jeśli powinien istnieć; dla świadomie usuniętej strony pozostaw właściwą odpowiedź. |
| 5xx | Występuje błąd serwera. | Zleć sprawdzenie logów i przyczyny awarii. |
| 200, ale komunikat błędu lub pusty dokument | Możliwy soft 404, czyli rozpoznanie strony jako błędu mimo kodu sukcesu. | Sprawdź zawartość zwracaną robotowi i działanie szablonu. |
Kody odpowiedzi wpływają na to, jak roboty Google pobierają i przetwarzają zasoby stron internetowych. Nie ustawiaj jednak kodu 200 dla rzeczywiście nieistniejącej podstrony tylko po to, aby zniknął błąd 404. To nie przywróci jej treści. [3]
Jeśli strona działa u Ciebie, a test Google ma problem z pobraniem, porównaj te warunki z administratorem hostingu. Zabezpieczenie antybotowe może wyświetlać robotowi ekran weryfikacji zamiast oferty. W zgłoszeniu podaj URL, godzinę testu i komunikat błędu. Sama informacja „na moim komputerze działa” nie pozwoli znaleźć przyczyny po stronie serwera.
Sprawdź również, czy robot otrzymuje zasadniczą treść. Jest to szczególnie przydatne, gdy zawartość pojawia się dopiero po wykonaniu JavaScript, czyli kodu uruchamianego w przeglądarce. W podglądzie przetestowanej strony porównaj HTML i zrzut ekranu z ofertą widoczną dla użytkownika. Brak opisu usługi, produktu albo głównej części artykułu jest konkretnym sygnałem do sprawdzenia renderowania. Zapisz także błędy skryptów i niezaładowane zasoby. Samo użycie JavaScript nie przesądza o problemie. [4]
Co pokazuje GSC
Google Search Console, w skrócie GSC, pozwala rozdzielić problem jednej podstrony od powtarzalnego problemu w witrynie. Do pierwszego służy sprawdzanie URL-a, a do drugiego raport „Indeksowanie stron”. Na początek wybierz jedną ważną podstronę, która nie pojawia się w Google, oraz podobną podstronę, która jest indeksowana. Takie porównanie ułatwi znalezienie różnicy w szablonie, ustawieniach lub treści.
W usłudze obejmującej badaną domenę wpisz pełny URL w górnym pasku Search Console. Odczytaj stan oraz szczegóły indeksowania. Jeśli Google nie zna adresu, wróć do jego odkrywalności: linków z innych podstron i mapy witryny. Jeżeli go zna, zapisz powód wykluczenia i datę ostatniego skanowania. Następnie uruchom test wersji opublikowanej, aby porównać zapisany stan z tym, co można pobrać obecnie. [6]
Do notatki diagnostycznej wystarczy kilka pól:
| Pole | Co zanotować |
|---|---|
| Badany URL | Pełny adres, bez skracania ścieżki i pomijania parametrów. |
| Cel biznesowy | Dlaczego ta strona powinna być dostępna w wyszukiwarce. |
| Stan w GSC | Wynik sprawdzenia wraz z powodem braku indeksacji. |
| Ostatnie skanowanie | Datę, którą porównasz z terminem wdrożenia zmian. |
| Wersja kanoniczna | Adres zadeklarowany w witrynie oraz wybrany przez Google, jeśli są dostępne. |
| Test bieżącej wersji | Dostępność treści i zauważone blokady. |
| Następne działanie | Jedna konkretna poprawka oraz osoba odpowiedzialna. |
Nie myl wyniku testu bieżącego z potwierdzeniem indeksacji. Po usunięciu blokady test może wypaść poprawnie, podczas gdy dane indeksu nadal opisują wcześniejszą wersję. Test wersji opublikowanej nie przewiduje też, który URL Google wybierze jako kanoniczny. Tę informację odczytuje się z danych o stanie znanym wyszukiwarce. [5]
Najczęstsze przyczyny wykluczenia widoczne w raportach wyznaczają następny krok diagnozy. Poniższe opisy upraszczają nazwy stanów w GSC:
| Stan adresu | Następny krok |
|---|---|
| Odkryty, jeszcze niepobrany | Sprawdź linki prowadzące do strony oraz ewentualne problemy z dostępnością serwera. |
| Pobrany, ale bez indeksacji | Oceń zawartość, podobieństwo do innych stron i to, co Google faktycznie otrzymało. |
| Wyłączony przez noindex | Ustal, czy zakaz jest celowy i skąd pochodzi. |
| Zablokowany przez robots.txt | Sprawdź regułę obejmującą dany adres. |
| Duplikat lub wersja alternatywna | Sprawdź stronę kanoniczną i porównaj ją z badanym URL-em. |
| Błąd pobrania lub przekierowania | Wróć do statusu HTTP i dostępności adresu docelowego. |
Raport nie jest listą samych usterek. Wykluczenie prawidłowego duplikatu, starego przekierowanego adresu czy usuniętego zasobu może być oczekiwanym zachowaniem. Grupuj problemy według przyczyny i rodzaju strony, zamiast próbować doprowadzić licznik niezindeksowanych URL-i do zera. [7]
Sam komunikat o pobraniu strony bez indeksacji nie dowodzi kary ani jednej konkretnej wady treści. Jakość treści i jej odrębność wymagają porównania dokumentów. Czy opis odpowiada na pytanie klienta? Czy inna podstrona przedstawia praktycznie tę samą ofertę? Czy po załadowaniu pozostaje pełna treść, czy tylko nagłówek i formularz? Zamiast dopisywać ogólniki, wskaż brakującą informację potrzebną do decyzji: zakres usługi, ograniczenia, proces lub odpowiedź na realne pytanie odbiorcy. Google zaleca ocenę użyteczności i oryginalnego wkładu, a nie pisanie do arbitralnej liczby słów. [15]
Jeżeli GSC potwierdza indeksację, a strony nie ma na wybrane słowa kluczowe, zmień kierunek analizy. Wtedy oceniasz jej dopasowanie do zapytania i widoczność, a nie tylko dostęp do indeksu. Przy nagłym zniknięciu ważnych stron sprawdź również raporty ręcznych działań i problemów z bezpieczeństwem oraz ewentualne usunięcia w Search Console. Nie zakładaj ich wystąpienia bez informacji w narzędziu. [16]
Blokady i canonical
Najważniejsze jest odróżnienie braku dostępu od zakazu indeksowania i wyboru innej wersji strony. Te trzy sytuacje mogą wyglądać podobnie z perspektywy właściciela firmy, ale wymagają innych poprawek. Usunięcie przypadkowej blokady bywa właściwe; usunięcie świadomie zastosowanej reguły z całego serwisu może odsłonić niepotrzebne adresy.
| Mechanizm | Zadanie | Co sprawdzić przy brakującej stronie |
|---|---|---|
| robots.txt | Sterowanie dostępem robotów do pobierania zasobów. | Czy reguła blokuje publiczną podstronę, którą Google ma odczytać? |
| noindex | Zakaz umieszczania treści w indeksie po odczytaniu reguły. | Czy występuje w HTML lub nagłówku odpowiedzi HTTP? |
| rel="canonical" | Wskazanie preferowanego adresu dla tej samej lub bardzo podobnej treści. | Czy prowadzi do właściwej wersji i zgadza się z pozostałymi sygnałami? |
robots.txt sprawdzaj dla właściwego hosta i ścieżki. Reguła blokująca cały katalog może obejmować także nową ofertę umieszczoną w tym katalogu. Ten plik nie jest jednak pewnym sposobem usuwania URL-a z Google: wyszukiwarka może poznać adres z linków, mimo że nie pobierze jego zawartości. Blokada skanowania może też uniemożliwić odczyt innych instrukcji na stronie. [8]
noindex sprawdź w dwóch miejscach. Może zostać wysłany w kodzie dokumentu jako znacznik meta, a także w odpowiedzi serwera jako X-Robots-Tag. Widoczny w kodzie zapis <meta name="robots" content="noindex"> jest sygnałem zakazującym indeksacji. Google musi móc pobrać stronę, żeby poznać tę regułę. Dodanie Disallow do robots.txt nie jest zatem sposobem na skuteczne przekazanie noindex. [9]
Źródłem niezamierzonej reguły może być ustawienie konkretnej podstrony, wspólny szablon albo konfiguracja serwera. W WordPressie sprawdza się ustawienia widoczności i wtyczki SEO; przy stronie statycznej — wygenerowany dokument oraz nagłówki hostingu. W obu przypadkach liczy się odpowiedź otrzymywana przez robota, a nie tylko stan przełącznika w panelu. Po zmianie skontroluj także wersję serwowaną z pamięci podręcznej.
Canonical porównaj z rzeczywistą zawartością. To wskazanie preferowanego URL-a, a nie bezwarunkowy nakaz dla Google. Jeśli oferta wskazuje stronę główną lub inną usługę, zweryfikuj, czy nie skopiowano błędnego ustawienia do szablonu. Jeżeli kilka adresów przedstawia identyczną treść i wybrana wersja jest właściwa, brak osobnej indeksacji każdego duplikatu nie wymaga naprawy. Ujednolić należy sprzeczne wskazania: canonical, przekierowania, linki wewnętrzne i adresy w mapie. [10]
Duplikacja treści wymaga decyzji o właściwej wersji. Nie używaj canonical jako automatycznej odpowiedzi na każdą niezindeksowaną stronę. Najpierw zdecyduj, czy dwa dokumenty mają odrębny cel. Dwie rzeczywiście różne usługi potrzebują treści pokazującej tę różnicę. Dwa techniczne warianty tej samej oferty mogą wymagać uporządkowania adresów. To decyzja o zawartości serwisu, a dopiero później o konkretnej regule.
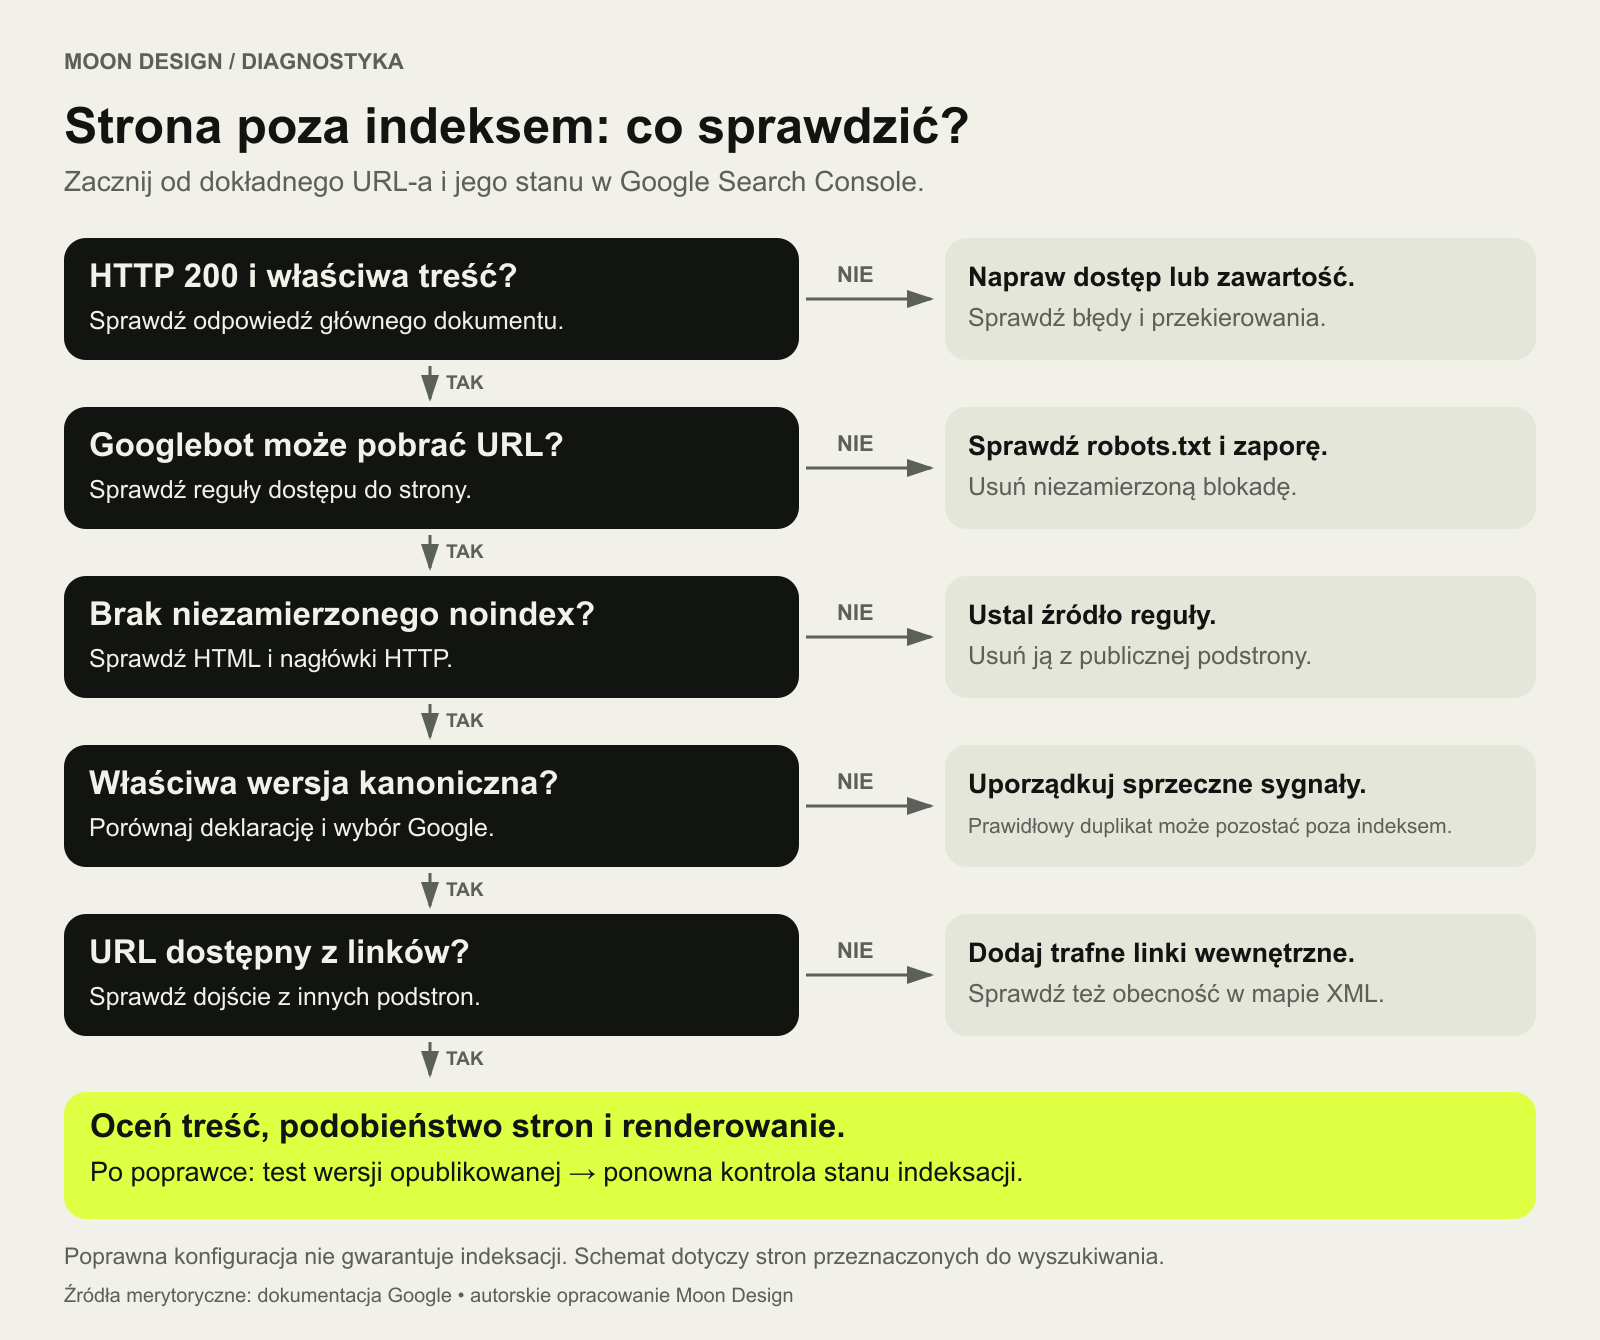
Na końcu sprawdź, jak można dotrzeć do adresu. Otwórz stronę główną lub odpowiednią kategorię i przejdź do badanej podstrony zwykłymi linkami. Jeśli znasz jej adres wyłącznie z panelu CMS, może brakować połączenia z resztą serwisu. Przemyślane linkowanie wewnętrzne powinno prowadzić do ważnych stron z miejsc, w których użytkownik ich oczekuje. Google zaleca odnośniki HTML z atrybutem href, które robot może odczytać. Sam przycisk uruchamiający skrypt nie zawsze spełnia tę funkcję. [11]
Mapa witryny XML uzupełnia tę kontrolę. Sprawdź, czy zawiera właściwy adres docelowy i czy Google może pobrać plik. Nie traktuj obecności w pliku sitemap jako dowodu indeksacji. Mapa pomaga przekazać informacje o adresach, szczególnie w nowych lub rozbudowanych serwisach, lecz nie zastępuje sensownej nawigacji ani dostępnej treści. [12]
W sklepie z wieloma wariantami adresów przyda się osobna analiza filtrów i ich indeksowania.
Weryfikacja po poprawce
Oddziel trzy wyniki: poprawkę wdrożono, Google mogło ją odczytać, adres został zindeksowany. To różne momenty. Jeśli w raporcie nadal widzisz starszą datę skanowania, nie masz jeszcze potwierdzenia, że zapisany stan uwzględnia nową wersję. Przygotuj krótką kartę zmiany, aby kolejna osoba nie zaczynała diagnozy od początku.
- Zapisz przyczynę i zakres. Podaj adresy objęte problemem, regułę do zmiany i oczekiwany stan. Nie wystarczy polecenie „naprawić indeksację”.
- Sprawdź odpowiedź po wdrożeniu. Powtórz kontrolę HTTP, zawartości, noindex i canonical. Uwzględnij pamięć podręczną strony i hostingu.
- Uruchom test wersji opublikowanej. Sprawdź, czy wykryta przeszkoda faktycznie zniknęła, i zapisz wynik. [6]
- Zgłoś ważny URL do ponownego pobrania. W przypadku niewielkiej liczby adresów można użyć prośby o indeksację; przy większych zbiorach pomóc może aktualna mapa witryny. [13]
- Wróć do danych o indeksacji. Porównaj datę ostatniego skanowania, aktualny powód wykluczenia oraz wybrany adres kanoniczny.
- Sprawdź pozostałe adresy tego samego typu. Jeśli problem wynikał ze wspólnego szablonu, kontrola jednej strony nie wystarcza do oceny całej poprawki.
Google podaje, że ponowne skanowanie może trwać od kilku dni do kilku tygodni. Nie jest to termin gwarantowanej indeksacji. Wielokrotne ręczne zgłaszanie tej samej strony nie przyspiesza pobrania, dlatego ważniejsze od kolejnych kliknięć jest usunięcie przeszkody i obserwacja stanu. [13]
Gdy dany problem w raporcie udostępnia opcję „Sprawdź poprawkę”, uruchom ją po kontroli adresów objętych zmianą. Pamiętaj jednak, że zakończenie weryfikacji problemu i indeksacja wszystkich oczekiwanych stron nie są tym samym wynikiem. Wykonaj ręczne sprawdzenie adresów obejmujących kluczowe podstrony. [7]
Przykład hipotetyczny: oferta pozostawiona z noindex. Właściciel firmy publikuje nową stronę usługi. Adres otwiera się poprawnie, zwraca 200 i jest podlinkowany z menu. W GSC widoczny jest jednak zakaz indeksowania. Kontrola odpowiedzi ujawnia noindex pozostawiony w szablonie po przygotowaniu wersji roboczej. To przykład objaśniający procedurę, nie opis realizacji ani wyniku klienta Moon Design.
| Etap | Co należy zrobić w tym przykładzie |
|---|---|
| Diagnoza | Potwierdzić noindex w odpowiedzi i sprawdzić, które strony korzystają z tego samego szablonu. |
| Decyzja | Oddzielić publiczne oferty od podstron, które nadal powinny pozostać wyłączone. |
| Wdrożenie | Usunąć niezamierzoną regułę z ofert i odświeżyć pamięć podręczną. |
| Odbiór techniczny | Potwierdzić dostępność treści i brak noindex w bieżącej odpowiedzi. |
| Kontrola w Google | Zgłosić ważny adres, a następnie sprawdzić późniejszy stan indeksacji. |
Usunięcie noindex rozwiązuje w tym scenariuszu potwierdzoną blokadę, ale nie uzasadnia obietnicy konkretnego terminu ani pozycji. Jeśli po kolejnym pobraniu pojawi się inny powód wykluczenia, należy go ocenić na podstawie nowych danych. Nie zmieniaj jednocześnie adresu, treści i kilku reguł tylko po to, żeby „coś ruszyło”: utrudni to ocenę, która poprawka była potrzebna.
Do wykonawcy przekaż zwięzłe zgłoszenie: „Ta podstrona ma być publiczną ofertą. GSC wskazuje wykluczenie, a w odpowiedzi znaleziono noindex. Proszę sprawdzić źródło reguły, zakres w szablonie i wynik po zmianie”. Dołącz URL, datę odczytu oraz wynik testu. To znacznie bardziej użyteczne niż sam zrzut licznika stron niezindeksowanych.
Jeśli problemy z indeksacją dotyczą wielu typów podstron albo wracają po wdrożeniach, potrzebna jest diagnoza ich wspólnej przyczyny i kolejności prac. Taki zakres obejmuje audyt SEO: od ustalenia problemu do planu poprawek, które można później sprawdzić.
Jeśli problem obejmuje więcej typów podstron, sprawdź co powinien zawierać audyt SEO z planem wdrożeń.
FAQ
Dlaczego wyniki operatora site: różnią się od danych GSC?
Operator site: pokazuje wybrane wyniki dla podanej domeny lub prefiksu adresu, a nie kompletny wykaz indeksu. Nawet zindeksowany URL może nie pojawić się w takim zapytaniu. Sprawdź też wariant adresu: www, protokół i ścieżkę. Do diagnozy konkretnej podstrony wykorzystuj sprawdzanie URL-a w GSC; wyniki site: traktuj jako pomocniczy podgląd. [14]
Czy zgłoszenie mapy witryny gwarantuje indeksację?
Nie. Przyjęcie mapy oznacza możliwość wykorzystania informacji o adresach, a nie obietnicę indeksowania każdej podstrony. Jeżeli ważny URL pozostaje poza indeksem, sprawdź jego własny stan i przyczynę. Ponowne wysłanie poprawnej mapy nie usunie noindex, błędu serwera ani problemu z zawartością. [12]
Jak odróżnić problem pojedynczej strony od problemu całej domeny?
Porównaj stronę główną, ważną ofertę, artykuł oraz nowy adres, którego dotyczy zgłoszenie. Jeżeli ten sam błąd występuje w wielu grupach, sprawdź wspólną konfigurację: hosting, robots.txt, nagłówki i szablony. Jeśli dotyczy tylko jednego typu stron, zacznij od jego ustawień. To próbka diagnostyczna, nie dowód stanu całej domeny; zakres potwierdź w raportach i szerszej kontroli adresów.
Źródła
- Google Search Central — wymagania techniczne wyszukiwarki.
- Google Search Central — jak działa wyszukiwarka Google.
- Google Crawling Infrastructure — wpływ kodów HTTP na roboty Google.
- Google Search Central — diagnozowanie problemów z JavaScript.
- Pomoc Search Console — narzędzie do sprawdzania adresów URL.
- Pomoc Search Console — sprawdzanie jednej strony i rozwiązywanie jej problemów.
- Pomoc Search Console — raport Indeksowanie stron.
- Google Search Central — działanie pliku robots.txt.
- Google Search Central — blokowanie indeksowania przez noindex.
- Google Search Central — wskazywanie wersji kanonicznej.
- Google Search Central — linki, które Google może odczytać.
- Google Search Central — zastosowanie map witryny.
- Google Search Central — prośba o ponowne skanowanie adresów.
- Google Search Central — możliwości i ograniczenia operatora site:.
- Google Search Central — tworzenie pomocnych i wiarygodnych treści.
- Pomoc Search Console — dlaczego strona nie pojawia się w wynikach.